Определение
IP-стрессер (часто называют booter или DDoS-бутер) — сервис или инструмент, который создаёт сетевую или HTTP-нагрузку на указанный IP или сайт. Цель легитимного сценария — измерить устойчивость: latency, потери пакетов, ошибки, лимиты соединений и «потолок» ёмкости.
В инженерной практике это инструмент проверки своей инфраструктуры: сервер, firewall, CDN, API-шлюз. Несанкционированные атаки на чужие ресурсы — правонарушение, и ответственные платформы это явно запрещают.
На русском рынке термины «стрессер» и «бутер» часто путают. Важно разделять маркетинг underground-сервисов и авторизованный load testing. Подробнее о принципе работы — в статье Как работают бутеры DDoS?
Исторически потолок ёмкости узнавали только во время аварии. IP-стрессер меняет порядок: вы сознательно планируете контролируемый прогон и смотрите, какой компонент сдаёт первым, пока команда на связи.
Имеет смысл тестировать свои origin, reverse proxy, API gateway, игровые/голосовые endpoints и staging, близкий к production по лимитам. Нельзя и бессмысленно целиться в чужие ресурсы без договора и окна теста.
Когда спрашивают «стрессер = бутер?», отвечайте процессом, а не сленгом. Есть идентификация, разрешение, мониторинг и план остановки — это инженерия. Есть анонимность и удар по третьим лицам — нет. См. Booters explained.
В 2026 году полезно сразу отделить поисковый сленг от инженерной практики. Запросы вроде «IP-стрессер» и «бутер» часто ведут к страницам про анонимную нагрузку, но для команд, которые отвечают за uptime, правильная рамка — авторизованное нагрузочное тестирование своей инфраструктуры. Платформа с аккаунтами, лимитами тарифа, проверкой цели и публичным AUP ближе к load-testing panel, чем к underground-сервису.
Используйте определение как фильтр для закупки: если вендор не может объяснить, как подтверждается ownership, как останавливается задача и где лежат правила использования, это не инструмент измерения ёмкости. Сверяйте ожидания с тарифами и документацией, а не с обещаниями «безлимитных Gbps».
Booter vs нагрузочный тест
Маркетинг «бутеров» часто маскирует незаконный DDoS-for-hire. Нагрузочный тест отличается целью, прозрачностью и разрешениями:
- есть владение или письменное разрешение на цель и окно теста;
- есть план: метод, длительность, concurrents, критерии остановки;
- есть мониторинг и разбор результатов после прогона;
- платформа проверяет target verification и блокирует злоупотребления.
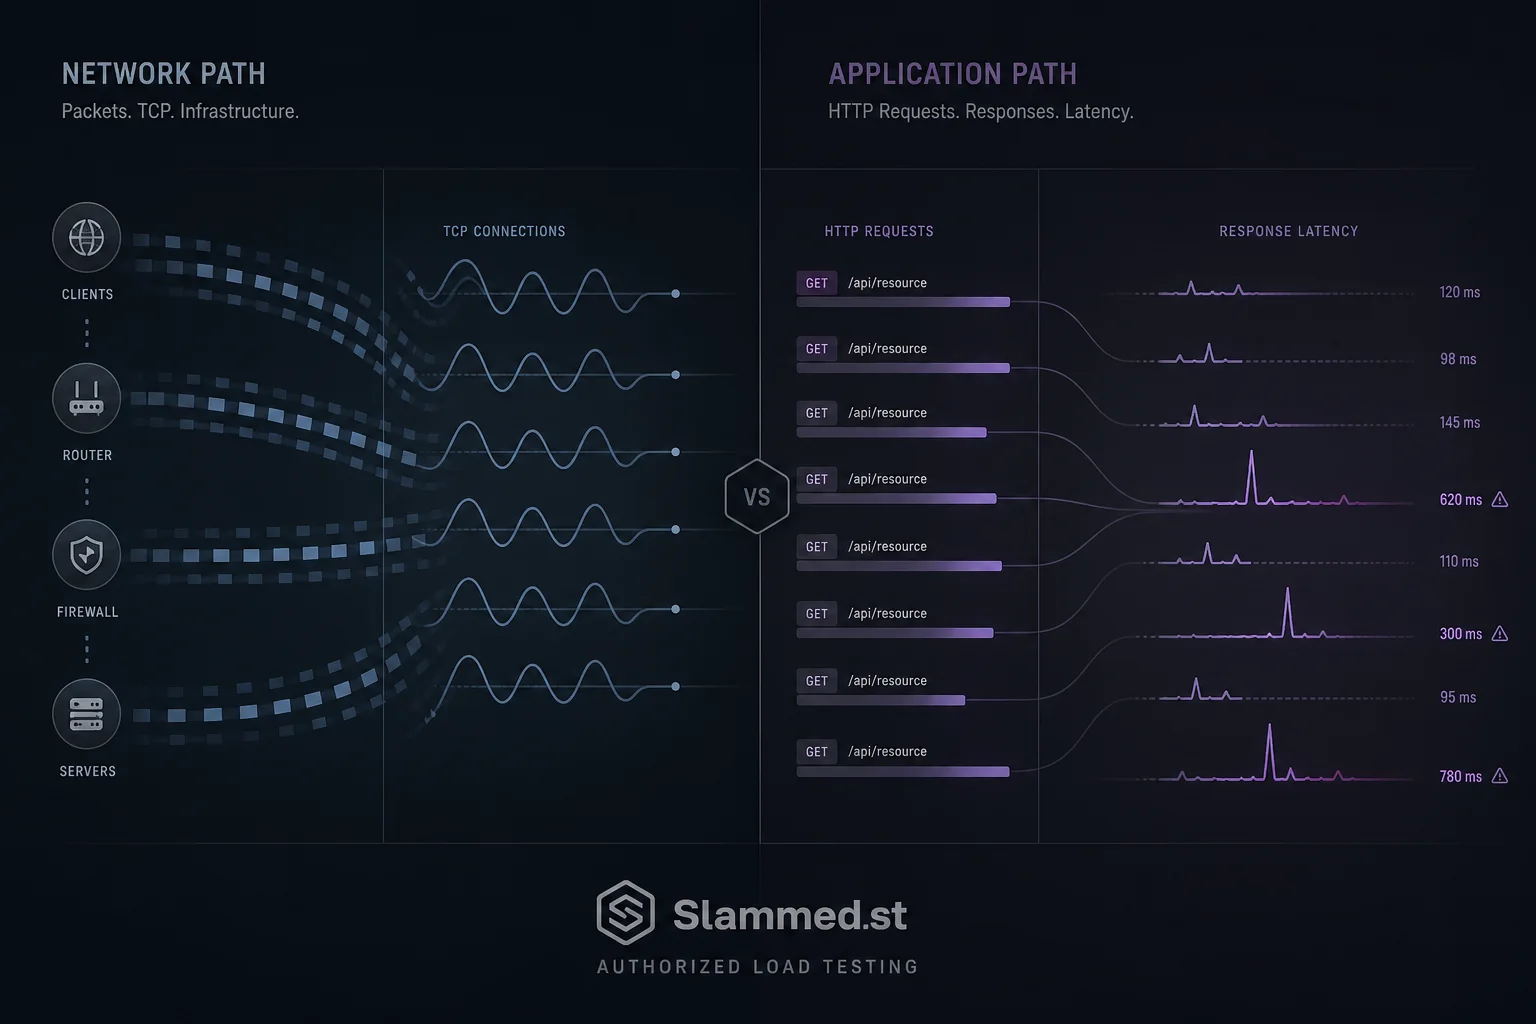
Slammed.st позиционируется как платформа авторизованного stress testing, а не анонимный attack service. Сравнение с underground-сленгом — в Booters explained.
Юридически и организационно разница огромна: у легитимного теста есть заказчик, scope, окно и артефакты (отчёт, тикеты, графики). У underground-бутера — обещание «положить» чужой хост и схема ухода от ответственности.
Если security или юристы сомневаются, покажите им Acceptable Use, Terms и внутренний runbook. Прозрачность платформы — часть доказательства добросовестности.
Когда это нужно
Команды запускают IP-стресс перед релизом, после смены firewall, при переезде на новый хостинг, перед маркетинговой кампанией или после инцидента, чтобы проверить, что защита снова держит пик.
Типичные вопросы, на которые отвечает тест: где рвётся conntrack, хватает ли bandwidth на edge, успевает ли autoscaling, не душит ли WAF легитимный трафик, выдержит ли checkout при одновременных сессиях.
Дополнительно тесты полезны после смены CDN, включения нового WAF-профиля, увеличения лимитов conntrack или перед сезоном продаж. Каждый такой change может незаметно откатить прошлую защиту.
Фиксируйте baseline в спокойный период — иначе любой пик кажется «аномалией», а любая mitigation — «успехом» без цифр.
Хороший повод для прогона — не только «большой релиз», но и тихие изменения: новый WAF-профиль, смена origin shield, миграция пула соединений, включение rate-limit на API. Именно такие правки часто ломают прошлый запас прочности. Заранее назначьте наблюдателей за CDN, APM и host-метриками, чтобы findings попали в тикеты, а не растворились в чате.
Если команда только входит в практику, начните со staging или lab, близкого к production по лимитам, затем переходите к production-adjacent окну с жёстким abort. Регистрация и первый контролируемый сценарий — через /register.
Безопасность и правила
Перед тестом подтвердите право на цель, ограничьте длительность и concurrents, мониторьте ошибки и latency, держите контакт эскалации с провайдером. Ознакомьтесь с Acceptable Use и Terms.
Практический чеклист на английском: How to run an authorized stress test. Для веб-целей см. также What Is a Website Stresser?
Отдельно договоритесь об abort: кто жмёт stop, какой p95/error rate считается красной зоной, кого звать у провайдера. Без этого тест превращается в импровизацию.
После остановки оставьте время на cool-down: липкие очереди и медленный scale-in — такие же findings, как точка поломки на пике.
Юридическая и операционная гигиена — часть теста, а не «бюрократия вокруг». Письменное окно, список целей, контакт эскалации и критерии stop должны существовать до первого пакета. Иначе даже добросовестный прогон выглядит как инцидент для NOC и провайдера. Держайте под рукой Acceptable Use и внутренний advisory-шаблон.
Операционные заметки и типичные ошибки
Частая ошибка — слабая коммуникация. Окно теста «известно инженерам», но неизвестно NOC, всё равно порождает хаос. Опубликуйте короткий advisory: время старта/стопа, ожидаемые симптомы, контакт эскалации и точный список целей.
Вторая ошибка — менять слишком много переменных сразу: метод, concurrents, правила кэша и режим WAF в одном прогоне. Меняйте одну главную переменную за итерацию, чтобы в отчёте сохранялась причинность.
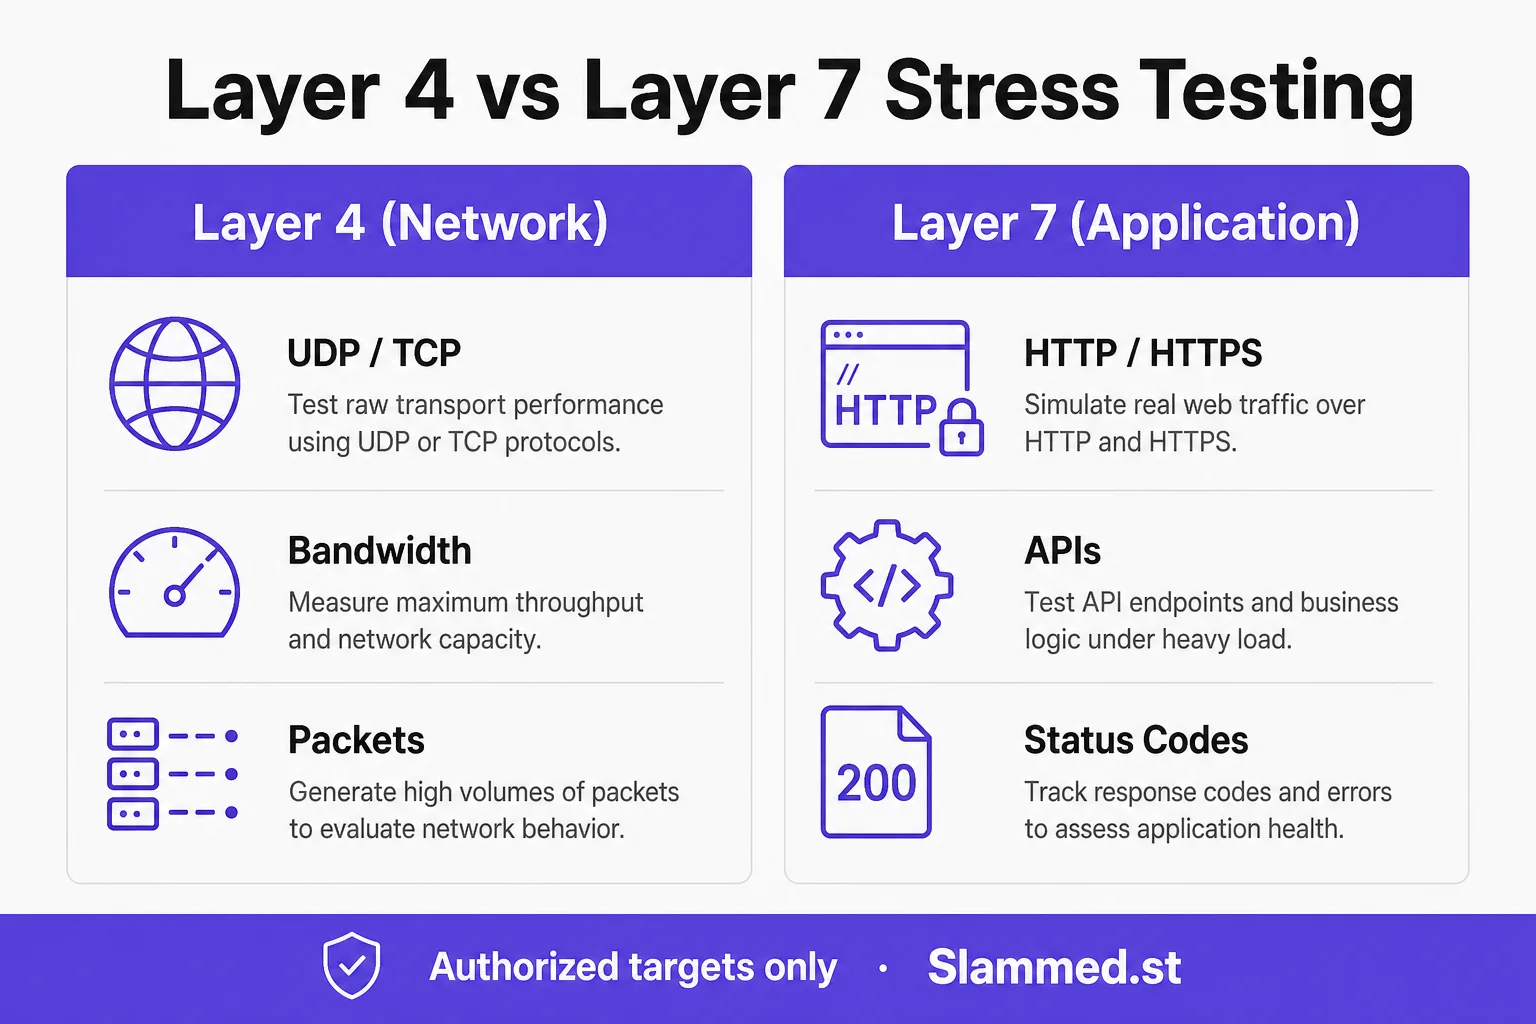
Заложите время на проверку recovery: очереди должны разгрузиться, autoscaling остыть, ошибки вернуться к baseline. Липкое восстановление — такой же важный finding, как точка поломки на пике. См. также чеклист авторизованного теста и L4/L7 гайд.
Когда будете готовы прогонять тесты на подтверждённой инфраструктуре, создайте аккаунт Slammed.st и выбирайте тариф под гипотезу, а не под рекламные Gbps. Ориентир по тарифам — на странице pricing.