Как устроен стрессер
Типичный IP-стрессер принимает параметры цели (IP/URL, порт, метод, длительность, concurrents) и распределяет генерацию трафика по воркерам. Клиент видит статус задачи и может остановить тест досрочно.
Контрольная плоскость хранит аккаунт, лимиты тарифа, историю задач и правила анти-абьюза. Чем прозрачнее биллинг и идентификация, тем ближе сервис к инженерному инструменту, а не к underground-бутеру. Базовые термины — в Что такое IP-стрессер?
Воркеры обычно стоят в разных сетях, чтобы нагрузка не упиралась в один uplink клиента. Контрольная плоскость режет задачу по лимитам тарифа и пишет историю — это важно для аудита внутри компании.
Если UI не даёт мгновенно остановить задачу, платформа непригодна для production-adjacent окон. Возможность stop — часть безопасности теста.
С инженерной точки зрения важно, что именно обещает архитектура: воспроизводимость, лимиты, историю и stop — или анонимный «boot anyone». Первый вариант годится для capacity planning; второй создаёт правовой и операционный риск. Разбор категорий — в booter vs authorized и на хабе authorized load testing.
При выборе платформы проверьте, видно ли в UI длительность, concurrents, статус воркеров и кнопку остановки за секунды. Без этого нельзя безопасно работать рядом с production. Практический онбординг: регистрация, сверка с тарифом и правилами на /legal.
L4 и L7 методы
Layer 4 бьёт по транспорту (TCP/UDP): соединения, пакеты, bandwidth, поведение firewall и scrubbing. Layer 7 имитирует клиентов HTTP(S): GET/POST, заголовки, TLS, keep-alive, API-вызовы.
Для веб-приложений L7 ближе к реальному пользовательскому пику; L4 полезен для сетевого периметра и фильтрации. Развёрнутое сравнение: L4 и L7 нагрузочное тестирование и англоязычный гайд Layer 4 vs Layer 7.
Ошибка новичков — гонять L7, когда гипотеза про bandwidth на стыке с ISP, или L4, когда ломается именно checkout. Слой должен следовать вопросу, а не «что мощнее выглядит в маркетинге».
Для веба почти всегда нужен хотя бы один L7-сценарий с реальными путями. Для периметра — короткий L4-пробник. Порядок и детали: L4 и L7.
На практике команды чередуют слои: короткий L4-пробник подтверждает, что периметр и pipe живы, затем L7 отражает реальные клиентские пути. Менять слой и concurrents одновременно — плохая идея: в отчёте пропадает причинность. Английский компаньон по выбору слоя: L4 vs L7 when to use.
Фиксируйте гипотезу в тикете до старта: «проверяем conntrack на firewall» или «проверяем p99 checkout при N сессиях». Тогда метод выбирается сам, без споров о «самой мощной» кнопке в панели.
Что смотреть в результатах
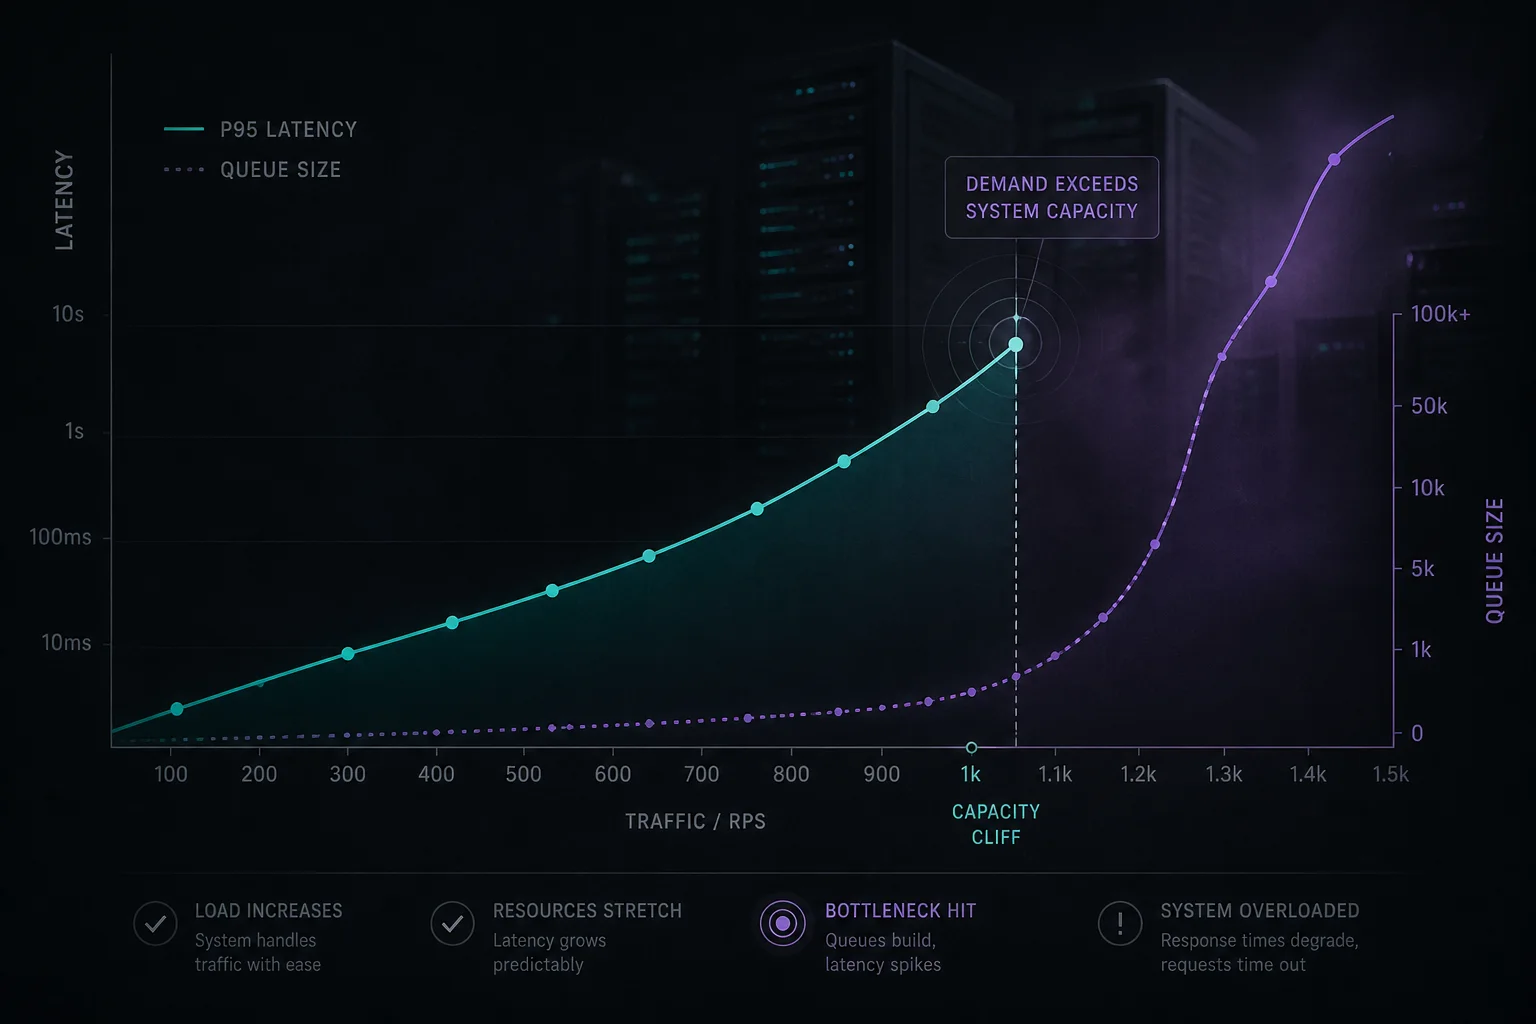
Сам факт «трафик пошёл» ничего не говорит. Смотрите сигналы деградации:
- рост latency и таймаутов;
- ошибки 5xx / connection reset / TLS handshake fail;
- насыщение CPU, NIC, conntrack, file descriptors;
- срабатывание WAF/rate-limit и ложные срабатывания на легитимных путях;
- время реакции autoscaling и recovery после остановки теста.
Именно эти метрики показывают, где усиливать защиту или масштабировать. Практический порядок шагов — в How to run an authorized stress test.
Снимайте метрики до, во время и после. Сравнение с baseline важнее абсолютного числа RPS. Зафиксируйте, какой компонент сдался первым — firewall, CDN, app, DB — и что произошло после stop.
Если мониторинг «молчит», сначала чините наблюдаемость, а не крутите concurrents. Иначе вы измеряете темноту.
Добавьте к списку метрик cool-down: 5–15 минут после stop. Липкие очереди, медленный scale-in и повышенный error rate после окончания нагрузки — отдельные findings, которые легко потерять, если закрыть дашборды сразу. Связанный чеклист: DDoS protection testing checklist.
Храните baseline спокойного периода рядом с результатами прогона. Без сравнения «шум теста» и «норма» почти неразличимы, и команда спорит о ощущениях вместо цифр. Документация процесса — в /docs.
Итоговый артефакт — короткий отчёт: гипотеза, метод, ступени concurrents, первый отказавший компонент, cool-down и список тикетов. Без него следующий релиз снова начнётся с нуля.
Важно о законности
«Бутер» в криминальном смысле — услуга атаки без разрешения цели. Авторизованный stress test — инженерная практика с владением/допуском, планом и контролем. Используйте только разрешённые цели и платформы с anti-abuse.
Правила Slammed.st: Legal & Acceptable Use, Terms.
Сохраняйте переписку с разрешением на тест и список целей. При вопросах хостера или юристов это экономит дни. Платформы вроде Slammed.st как раз требуют verification, чтобы снизить риск злоупотреблений.
Если коллеги всё ещё путают сленг и инженерию, отправьте их на хаб authorized load testing и сравнение booter vs authorized. Для запуска на своих целях — регистрация и сверка тарифа на /pricing.
Операционные заметки и типичные ошибки
Частая ошибка — слабая коммуникация. Окно теста «известно инженерам», но неизвестно NOC, всё равно порождает хаос. Опубликуйте короткий advisory: время старта/стопа, ожидаемые симптомы, контакт эскалации и точный список целей.
Вторая ошибка — менять слишком много переменных сразу: метод, concurrents, правила кэша и режим WAF в одном прогоне. Меняйте одну главную переменную за итерацию, чтобы в отчёте сохранялась причинность.
Заложите время на проверку recovery: очереди должны разгрузиться, autoscaling остыть, ошибки вернуться к baseline. Липкое восстановление — такой же важный finding, как точка поломки на пике. См. также чеклист авторизованного теста и L4/L7 гайд.
Когда будете готовы прогонять тесты на подтверждённой инфраструктуре, создайте аккаунт Slammed.st и выбирайте тариф под гипотезу, а не под рекламные Gbps. Ориентир по тарифам — на странице pricing.
После прогона сохраните advisory, скрины метрик и список тикетов в одном месте: так следующий инженер повторит сценарий без раскопок в чатах, а security увидит управляемый процесс, а не разовый «эксперимент».